Skip to content

Всё о GUC по порядку: hot_standby_feedback

Автор Christophe Pettus: All Your GUCs in a Row: hot_standby_feedback


hot_standby_feedback не устраняет проблему. Он перемещает её — с резервного сервера на первичный, и вопрос о том, является ли это хорошим обменом, — это и есть весь вопрос.


Проблема заключается в конфликтах восстановления, которые отменяют долго выполняющиеся запросы на резервном сервере. Резервный сервер воспроизводит изменения первичного, одновременно отвечая на читающие запросы, и когда первичный очищает vacuum мёртвые версии строк, воспроизведение этой очистки на резервном сервере сталкивается с любым запросом, который всё ещё полагается на эти версии. Резервный сервер разрешает столкновение, убивая запрос, и пользователь видит ERROR: canceling statement due to conflict with recovery. hot_standby_feedback останавливает это, прося первичный сервер вообще не удалять эти строки. Стоимость ложится на первичный сервер в виде раздувания, потому что строки, которые он иначе освободил бы, теперь удерживаются запросом, выполняющимся на другой машине.


Именно поэтому он выключен по умолчанию. Значение по умолчанию подразумевает, что запросы резервного сервера не должны иметь возможности «дотянуться» и ограничивать обслуживание первичного. Его включение — это сознательное решение позволить им это.

Продолжить чтение "Всё о GUC по порядку: hot_standby_feedback"
Автор Alexey Evlampiev: Your ALTER TABLE Is Fast. The Queue Behind It Is Not


Изменение схемы, которое выполняется шесть миллисекунд, всё ещё может остановить каждое чтение из таблицы на шестнадцать секунд — ущерб наносит ожидание, а не работа.


Вот один и тот же оператор, выполненный дважды для одной и той же таблицы — PostgreSQL 16.14 в локальном контейнере, таблица orders на 100 000 строк, конкурирующая сессия удерживается открытой через pg_sleep. Это иллюстративные числа с одной машины, а не бенчмарк; важен сам ratio, и вы можете воспроизвести его примерно за минуту.


-- Без конкуренции:
ALTER TABLE orders ADD COLUMN note text;
Time: 5.786 ms

-- С одним обычным долго выполняющимся SELECT, открытым на таблице:
ALTER TABLE orders ADD COLUMN note text;
Time: 18065.050 ms (00:18.065)


Второй запуск медленный не потому, что работа тяжелее. Работа идентична и занимает около шести миллисекунд в обоих случаях — добавление столбца без значения по умолчанию не касается ни одной строки, оно лишь редактирует каталог. Восемнадцать секунд тратятся на ожидание блокировки, и пока этот оператор ждёт, он делает кое-что похуже, чем просто медленно работает: он останавливает несвязанных читателей, которые иначе выполнились бы мгновенно.


Именно это стоит усвоить, и это верно независимо от того, какой инструмент миграции вы используете. Время выполнения без конкуренции говорит вам, сколько стоит оператор, когда ничто не стоит у него на пути; оно не предсказывает, во что он обойдётся вашим пользователям. Режим блокировки, время, проведённое в ожидании, и длина окружающей транзакции дополняют эту картину — и только первое число появляется в таймингах ваших миграций.


Безопасное развёртывание с точки зрения блокировок состоит из двух половин. Одна — это проектирование операторов: выбор форм SQL, которые берут более слабые блокировки или откладывают свою дорогостоящую работу до момента, когда блокировка слаба. Другая — это структура программы: выбор того, где проходят границы ваших транзакций, потому что блокировка живёт до конца своей транзакции, а не до конца своего оператора. Эта статья — о первой половине. Она чисто про PostgreSQL и применима независимо от того, с помощью чего вы развёртываете.

Продолжить чтение ""

Всё о GUC по порядку: hot_standby

Автор Christophe Pettus: All Your GUCs in a Row: hot_standby


hot_standby — это переключатель, который решает, является ли резервный сервер запасным, на который можно только переключиться, или репликой, с которой можно ещё и читать. По умолчанию он установлен во второе положение начиная с PostgreSQL 10, поэтому для большинства людей, использующих репликацию сегодня, это переключатель, уже находящийся в нужном положении, которое никогда не приходится трогать.


Это логический параметр, по умолчанию включён, его контекст — postmaster, поэтому он фиксируется при запуске сервера. Он включает возможность подключаться к серверу, находящемуся в режиме восстановления, воспроизводящему WAL из архива или от потокового первичного сервера, и выполнять против него запросы только для чтения, пока это воспроизведение продолжается. Часть «только для чтения» обеспечивается принудительно, а не на доверии: любая сессия, подключённая во время восстановления, принудительно переводит свои транзакции в режим только для чтения, что бы клиент ни запрашивал. Функция, которую он включает, — Hot Standby — появилась в PostgreSQL 9.0 и отличает современную читающую реплику от более старого «тёплого резерва» (warm standby), который мог только сидеть и воспроизводить WAL до момента повышения.

Продолжить чтение "Всё о GUC по порядку: hot_standby"

Всё о GUC по порядку: hba_file

Автор Christophe Pettus: All Your GUCs in a Row: hba_file


hba_file — это указатель, а не политика. Он сообщает серверу, где найти pg_hba.conf — файл, который фактически решает, кто может подключиться, откуда, под каким именем и каким методом аутентификации. Обо всех этих решениях hba_file ничего не говорит. Его единственная задача — адрес.


Это строка, её контекст — postmaster, поэтому она фиксируется при запуске сервера, и её можно установить в postgresql.conf. Значение по умолчанию — pg_hba.conf в каталоге данных, куда initdb записывает его при создании кластера. У вас очень редко будет причина его менять, и все возможные причины сводятся к желанию, чтобы файл аутентификации находился где-то вне каталога данных.

Продолжить чтение "Всё о GUC по порядку: hba_file"

Как работают пользовательские типы в PostgreSQL: полное руководство

Пересказ статьи Grant Fritchey. How User-Defined Types work in PostgreSQL: a complete guide


Узнайте, как работать с определяемыми пользователем типами в PostgreSQL, в том числе как эффективно их определять, использовать и управлять ими. В этом руководстве объясняется, как пользовательские типы могут улучшить проектирование схемы, усилить целостность данных и поддерживать более ясные и более удобные в обслуживании структуры баз данных в реальных приложениях.

Я уверен, что не одинок, когда говорю: иногда я отвлекаюсь. В данном конкретном случае я не собирался изучать пользовательские типы (UDT) в PostgreSQL — я просто хотел протестировать поведение, связанное с созданием UDT. Но как только я начал читать, меня зацепило. Я имею в виду четыре разных UDT с разным поведением. Это очень круто. Давайте займемся этим.
Продолжить чтение "Как работают пользовательские типы в PostgreSQL: полное руководство"

Новости за 2026-09-05 - 2026-09-11

§ Новая задача от Pegoopik (1 балл) выставлена для обсуждения под номером 303.

§ Популярные темы недели на форуме

Топик		Сообщений	Просмотров
58 (Learn) 6 6
207 (SELECT) 2 4
53 (Learn) 2 6

§ Авторы недели на форуме

Автор		Сообщений
Steamboat 3
Murderface_ 3
Demon_gr 2
pegoopik 2
selber 2
Продолжить чтение "Новости за 2026-09-05 - 2026-09-11"

Почему SUM после JOIN завышает итог — и почему DISTINCT не всегда помогает

Автор Глеб Зайцев


В отчёте два оплаченных заказа на 1 600 рублей, а запрос возвращает 2 600. Синтаксис правильный, ошибок выполнения нет. Причина может быть в том, что после соединения таблиц одна и та же сумма заказа встречается несколько раз.

Разберём этот случай на маленькой базе SQLite и проверим исправление не только на удачном примере, но и на пограничных данных. Для запуска полного скрипта в конце статьи нужны Python 3 и встроенный модуль `sqlite3`. Внешняя база, аккаунт и дополнительные пакеты не требуются.
Продолжить чтение "Почему SUM после JOIN завышает итог — и почему DISTINCT не всегда помогает"

Всё о GUC по порядку: hash_mem_multiplier

Автор Christophe Pettus: All Your GUCs in a Row: hash_mem_multiplier


Сортировки и хэш-операции имеют разное отношение к памяти, и этот параметр существует потому, что PostgreSQL большую часть своей истории делал вид, что это не так.


hash_mem_multiplier — это значение с плавающей точкой, по умолчанию 2.0, контекст — пользовательский, диапазон от 1.0 до 1000. Что он делает, легко сформулировать: операциям на основе хэширования разрешено использовать work_mem, умноженный на это значение, в то время как операции на основе сортировки получают обычный work_mem. При значениях по умолчанию сортировка может использовать 4 МБ, прежде чем сбросить данные на диск, а хэш-таблица может использовать 8 МБ. Под хэш-таблицами здесь понимаются те, что стоят за хэш-соединениями, хэш-агрегацией, узлами memoize и хэш-обработкой подзапросов IN.

Продолжить чтение "Всё о GUC по порядку: hash_mem_multiplier"

Всё о GUC по порядку: gss_accept_delegation

Автор Christophe Pettus: All Your GUCs in a Row: gss_accept_delegation


gss_accept_delegation — это логический параметр, по умолчанию выключен, его контекст — sighup. Он управляет тем, будет ли ваш сервер PostgreSQL принимать учётные данные Kerberos, которые передаёт ему клиент, и причина, по которой он по умолчанию выключен, заключается в том, что принятие этих данных означает, что сервер сможет затем действовать от имени этого пользователя по отношению к другим системам. Это один из тех параметров, где значение по умолчанию является безопасным выбором, а его включение — это сознательное решение принять на себя риск в обмен на определённую возможность. Поэтому полезное, что может сделать эта статья, — это объяснить саму возможность, риск и то, как определить, действительно ли вы хотите этот обмен.

Продолжить чтение "Всё о GUC по порядку: gss_accept_delegation"

Всё о GUC по порядку: gin_fuzzy_search_limit

Автор Christophe Pettus: All Your GUCs in a Row: gin_fuzzy_search_limit


Это название вводит в заблуждение сразу дважды. Параметр никак не связан с нечётким сопоставлением, то есть с поиском по триграммному сходству или близости написания, ради которого обычно обращаются к pg_trgm. И это на самом деле не совсем ограничение поиска. Неопределённость заключается в размере набора результатов: этот параметр фактически велит PostgreSQL вернуть меньше строк, чем соответствует вашему запросу, причём выбранных случайным образом, и ничего вам об этом не сообщить.


Из-за этого параметр почти уникален среди GUC. Многие параметры позволяют обменивать один ресурс на другой, а некоторые жертвуют надёжностью ради скорости. Этот же жертвует корректностью ради скорости.


Целочисленный параметр, по умолчанию 0, что означает отсутствие ограничения; контекст user, допустимое значение — до 2147483647.

Продолжить чтение "Всё о GUC по порядку: gin_fuzzy_search_limit"

Всё о GUC по порядку: семейство geqo

Christophe Pettus: All Your GUCs in a Row: The geqo Family


Семь параметров, одна функция и разумная цель — никогда не использовать ни один из них.


geqo, geqo_threshold, geqo_effort, geqo_pool_size, geqo_generations, geqo_selection_bias и geqo_seed — все они настраивают Генетический оптимизатор запросов (Genetic Query Optimizer), альтернативный поиск порядка соединений, к которому PostgreSQL прибегает, когда в запросе слишком много отношений для полного перебора обычным планировщиком. Все семь параметров имеют контекст user, поэтому любой из них можно установить для сессии, роли или базы данных.


Причина рассматривать их как группу в том, что шесть из семи имеют значение только в том случае, если вы уже «проиграли». Тот, который имеет значение, — это geqo_threshold, и он определяет, вступают ли в игру остальные шесть вообще.

Продолжить чтение "Всё о GUC по порядку: семейство geqo"

Как работает многостолбцовая статистика

Пересказ статьи Brent Ozar. How Multi-Column Statistics Work


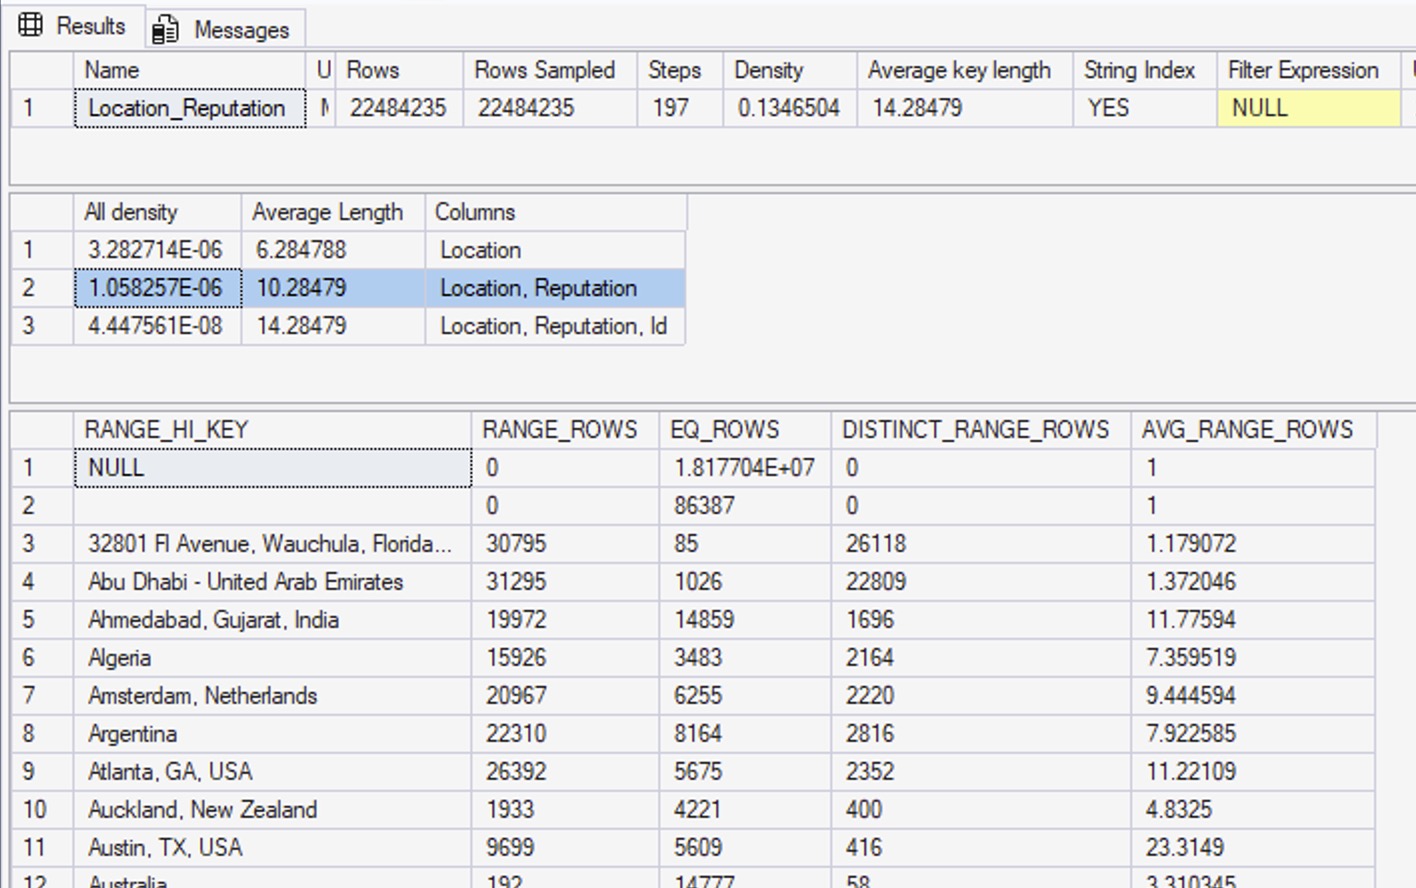
Краткий ответ: в реальных ситуациях работает только первый столбец. Когда SQL Server необходимы данные о втором столбце, он строит вместо этого свою собственную статистику по этому столбцу (предполагая, что ее не существует) и использует эти две статистики совместно - но на самом деле они не связаны.

Чтобы дать более подробный ответ, давайте возьмем большую версию базы данных Stack Overflow, создадим двухстолбцовый индекс на таблице Users, а затем посмотрим на полученную статистику:

DropIndexes;
GO
CREATE INDEX Location_Reputation
ON dbo.Users(Location, Reputation);
GO
DBCC SHOW_STATISTICS('dbo.Users', 'Location_Reputation');
GO

Вывод DBCC SHOW_STATISTICS показывает, что мы получили 22 миллиона строк в этой таблице. Итак, что гистограмма статистики говорит нам о связи между locations и reputations?


Продолжить чтение "Как работает многостолбцовая статистика"

MVCC в PostgreSQL — это плохо, как и у других

Radim Marek: PostgreSQL's MVCC is bad. So is everyone else's


Первое, что вы, вероятно, узнаете о Postgres, если следите за людьми, которым он не нравится, — это то, что MVCC — это плохо. Ошибка дизайна сорокалетней давности. Её признаки повсюду: раздутые таблицы, удваивающиеся в размере, 32-битный лимит счётчика транзакций, бесконечная борьба с VACUUM, кошмары с мёртвыми кортежами. Это подтверждается и авторитетами: Uber измерил амплификацию (здесь - усиление) записи в 2016 году и ушёл на MySQL из-за этого; группа баз данных Энди Павло назвала MVCC частью PostgreSQL, которую они ненавидят больше всего. Это реально. Postgres настолько плох, насколько это возможно.


Хотя всё это не преувеличено, это сводится к реальному дизайнерскому выбору. Раздувание, амплифицированные записи, постоянный уход за VACUUM — все эти обвинения связаны с решением, а не с дефектом, и мы воспроизводим каждое из них ниже на живом экземпляре PostgreSQL 19 beta2, чтобы вы могли увидеть ущерб своими глазами. Но вердикт, который распространяется из сообщества в сообщество, всегда останавливается на один вопрос раньше: по сравнению с чем? Что вместо этого делают все другие движки, и во что это обходится?


Потому что MVCC не является опциональным. Любая база данных, которая хочет, чтобы читатели не блокировали писателей, должна где-то хранить несколько версий строк, и каждый движок, который это делает, отвечает на одни и те же четыре вопроса:


  1. Где живут старые версии? В самой таблице или в отдельной структуре?

  2. В каком направлении указывают цепочки версий? От старых к новым или от новых к старым?

  3. На что указывают индексы? На физическое расположение строки или на логический ключ?

  4. Кто выполняет очистку и когда? Фоновый процесс позже или сама транзакция?


Ответы PostgreSQL: в таблице, от старых к новым, физическое расположение, фоновый процесс позже. Каждая стоимость, которую перечисляют критики, следует из этих четырёх ответов. И каждая альтернатива — это другой набор ответов, где счёт выставляется кому-то другому: писателю, читателю истории, tempdb, кэшу, компактору. Одна из них потратила годы инженерной работы, чтобы купить одно свойство, которое дизайн PostgreSQL имел бесплатно с первого дня. Все они терпят неудачу по-разному, когда транзакция остаётся открытой во время обеда...

Продолжить чтение "MVCC в PostgreSQL — это плохо, как и у других"

Всё о GUC по порядку: full_page_writes

Автор Christophe Pettus: All Your GUCs in a Row: full_page_writes


full_page_writes — это логический параметр, по умолчанию включён, его контекст — sighup, устанавливается в postgresql.conf или в командной строке. Это причина, по которой аварийное восстановление вообще работает, и это также причина, по которой ваш график WAL имеет «пилообразную» форму.

Продолжить чтение "Всё о GUC по порядку: full_page_writes"

CONVERT_IMPLICIT: Почему SQL Server игнорирует ваш индекс

Пересказ статьи rebecca@sqlfingers. CONVERT_IMPLICIT: Why SQL Server Is Ignoring Your Index


Вы построили индекс и протестировали запрос в SSMS. Index seek. Идеально. Вы пошли домой.

Между тем ваше приложение сканировало каждую строку в этой таблице, начиная со дня его запуска.

Это CONVERT_IMPLICIT - один из наиболее скрытых убийц производительности в SQL Server. Никаких ошибок. Никаких предупреждений в журнале приложения. Запрос возвращает правильные результаты, а ваш индекс отлично структурирован, но оптимизатор его не использует, поскольку тип данных, приходящих из приложения, не соответствует типу данных столбца - и SQL Server должен преобразовывать каждую строку, прежде чем он сможет выполнить сравнение.

Здесь рассказывается, как найти, понять и доказать разработчику, который продолжает говорить вам, что "все прекрасно работает на моей машине". Продолжить чтение "CONVERT_IMPLICIT: Почему SQL Server игнорирует ваш индекс"